Pra fazer a influencer IA falar em vídeo, use um modelo que gera a voz junto com a imagem, anexe a foto dela como referência e escreva a fala, entre aspas, dentro do prompt. Na Avatrix, isso é um card de Vídeo no modo Criativo com o Gemini Omni Flash 1.1, que gera de 3 a 10 segundos com áudio nativo e põe a boca no ritmo da fala, sem gravar nem dublar nada.
Este guia é da equipe da Avatrix. As regras de prompt vêm das páginas oficiais do Google, conferidas em 04/11/2026, e as telas e o vídeo de exemplo vêm do guia do influencer IA de nicho, onde o Seu João conta uma dica caseira em português.
O que é sincronia labial em vídeo de IA?
É a boca da personagem se mexendo no tempo exato das palavras. Sem ela, o vídeo parece dublado, e o seguidor percebe na hora.
Existem quatro jeitos de dar voz à personagem com a boca no tempo. A diferença está em quem faz a voz e quem faz a boca acompanhar:
| Caminho | Como funciona | Ponto forte | Ponto fraco |
|---|---|---|---|
| Áudio nativo | O modelo gera vídeo e voz juntos, a partir do prompt | Uma geração só, boca e voz nascem juntas | Trechos curtos, voz escolhida pelo texto |
| Voz separada + sincronia labial | Você gera ou escolhe uma voz, cria o áudio e uma ferramenta ajusta a boca ao áudio | A voz é sempre a mesma, palavra por palavra | Mais etapas e mais de uma ferramenta |
| Sua própria voz | Você grava a fala e usa o áudio como base da sincronia | Controle total da fala | Você precisa gravar cada vídeo |
| Avatar falante | Você manda um texto ou áudio e um avatar lê | Vídeo longo, roteiro de minutos | Cara de apresentador, cena mais parada |
Pra influencer de rede social, com vídeo curto e cena de vida real, o áudio nativo é o caminho deste guia. Pra apresentador falando por minutos, o comparativo Avatrix vs HeyGen mostra onde a ferramenta de avatar falante leva vantagem.
Qual modelo faz a influencer IA falar em português?
Na Avatrix, o Gemini Omni Flash 1.1, que gera vídeo de 360p ou 720p com áudio nativo, de 3 a 10 segundos, em 9:16 ou 16:9. O áudio vem sempre junto: não tem como gerar o vídeo mudo nesse modelo.
O Google também trata o Omni Flash (gemini-omni-1.1-flash) como o modelo recomendado pra gerar vídeo na documentação do AI Studio, conferida em 04/11/2026. A mesma página avisa que a prévia do Veo 3.1 na Gemini API foi desligada em 22/10/2026.
Sobre o idioma, um cuidado: a página oficial do Gemini Omni, conferida em 04/11/2026, cita "Speech Adherence" (fidelidade à fala) entre os critérios de avaliação, mas não publica uma lista de idiomas. O português funciona na prática, como mostra o vídeo do Seu João, mas vale escrever o idioma no prompt e conferir cada resultado.
De 7 de março a 1º de junho de 2026, a plataforma concluiu 1.923 vídeos, segundo o banco de dados de produção.
Como fazer a influencer IA falar, passo a passo?
1. Qual foto usar de entrada?
Use uma foto da influencer de frente pra câmera, com a boca à mostra e as mãos longe do rosto. O vídeo herda o rosto da foto, e a boca precisa estar visível pra sincronia funcionar.
O guia de personagem consistente mostra o que acontece quando a foto de entrada tem objeto na frente do corpo: um celular virou um borrão flutuando no vídeo. Pra fala, evite também rosto de perfil, mão no queixo e cabelo cobrindo a boca.
2. Onde fica o modo que aceita fala?
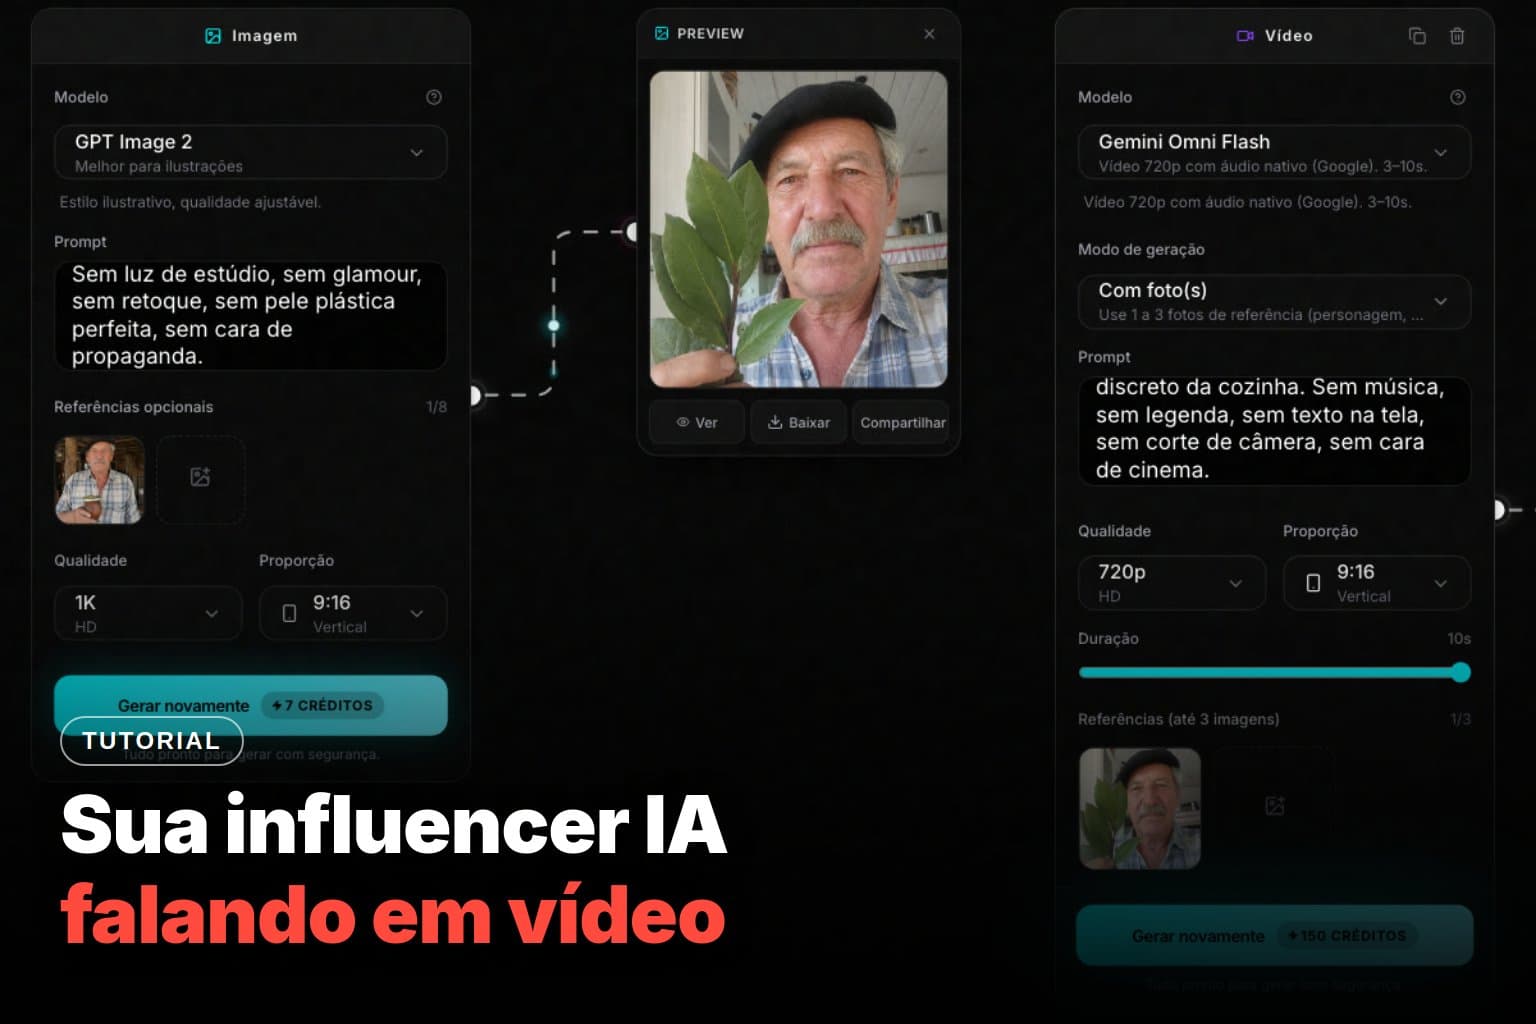
No Workflow, clique em + Nova criação e escolha VÍDEO. O card pergunta o modo:
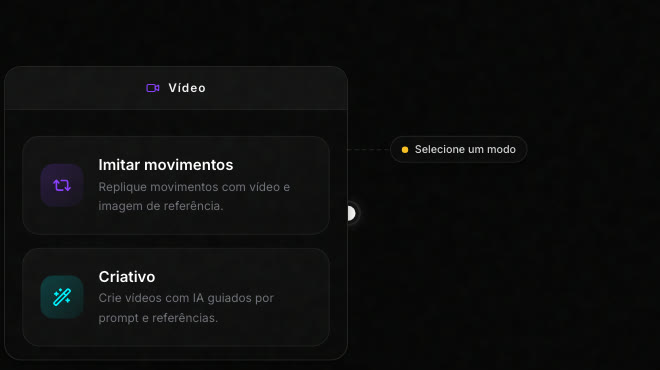
O Imitar movimentos copia o movimento de um vídeo que já existe e não lê fala do prompt. Pra influencer falar, é o Criativo.
3. Como configurar o card de Vídeo?
Três ajustes no card:
- Modelo: Gemini Omni Flash 1.1, o de áudio nativo.
- Referência: a foto da influencer. Quem decide como a imagem é usada é o modo escolhido no card, não quantas imagens você anexa. No modo de primeiro quadro, só a 1ª imagem entra: ela vira o quadro inicial e é animada. No modo de referência, entram até 3 imagens, que guiam a personagem numa cena nova; é só nesse modo que a 2ª e a 3ª imagem contam.
- Duração: até 10 segundos. Ajuste ao tamanho da fala.

O botão de gerar mostra o custo em créditos antes de gastar.
4. Como escrever a fala no prompt?
Escreva, nesta ordem: quem é a personagem (a da referência), a cena, quem fala e em que idioma, o jeito de falar, a fala entre aspas e o que você quer de áudio. O guia oficial de prompt de vídeo do Google Cloud, conferido em 04/11/2026, recomenda dizer claramente se você quer áudio e descrever o áudio em frases separadas da parte visual. Ele separa três tipos de som: fala, efeito sonoro e ruído ambiente.
Modelo pra copiar e trocar o que está entre colchetes:
Use a foto de referência anexada como a personagem e o cenário EXATOS
(mesmo rosto, mesmo cabelo, mesma roupa — não modificar a identidade).
Vídeo vertical 9:16 com cara de story gravado no celular, câmera na mão,
leve tremido natural. Ela olha pra câmera e fala em português brasileiro,
[com sotaque carioca, voz animada e ritmo de conversa com amiga].
FALA: "[Uma ou duas frases curtas, do jeito que você falaria em voz alta.]"
Ela gesticula de leve e sorri no final.
Áudio: só a voz dela e o som ambiente discreto do [quarto].
Sem música, sem legenda, sem texto na tela, sem corte de câmera.
Quatro regras deixam a fala mais limpa:
- Diga quem fala. "Ela olha pra câmera e fala" amarra a voz à boca da personagem. Sem isso, o modelo pode pôr narração por cima.
- Escreva o idioma e o sotaque. "Português brasileiro" no prompt, mais o sotaque e o tom que combinam com a personagem.
- Uma ou duas frases. Em 10 segundos cabe pouca fala dita sem pressa. Roteiro grande sai acelerado ou cortado.
- Peça "sem legenda, sem texto na tela". Senão o modelo pode escrever a fala no vídeo em vez de só falar.
5. Como conferir o vídeo antes de postar?
Assista com som, duas vezes. Na primeira, olhe só a boca: as sílabas fortes batem com o movimento? Na segunda, ouça só a fala: saiu cada palavra do roteiro, na ordem, sem sotaque trocado? Confira também o rosto nos momentos em que ela gesticula ou vira a cabeça, que é onde a identidade costuma escapar.
No guia do Seu João, que gerou o quadro antes num card de Imagem, o Workflow ficou assim, um card puxando o outro:

Como manter a mesma voz em todos os vídeos?
No áudio nativo, a voz é gerada de novo em cada vídeo. O que você controla é a descrição: copie o mesmo trecho de voz (sotaque, idade, timbre e ritmo) em todo prompt e troque só a fala. Ouça cada vídeo antes de postar e descarte o que fugir da voz da personagem.
Se a voz precisa ser idêntica, palavra por palavra, em todos os vídeos, o caminho mais seguro é o da voz separada com sincronia labial, na tabela do começo: uma voz fixa gerada à parte, com a boca ajustada depois.
Por que a boca sai fora do tempo, e como corrigir?
A fala ficou corrida ou cortada?
A fala é longa demais pra duração. Corte o roteiro pela metade ou aumente a duração até o máximo de 10 segundos. Pra um vídeo maior, divida a fala em trechos e gere um vídeo por trecho, com a mesma foto de referência.
A boca não mexe ou mexe errado?
Quase sempre é a foto de entrada: rosto de perfil, mão ou objeto na frente da boca, ou cabelo cobrindo os lábios. Troque por uma foto de frente e mãos vazias e gere de novo.
Saiu outra voz, narração ou outro idioma?
O prompt não amarrou a fala à personagem. Escreva "ela olha pra câmera e fala em português brasileiro" antes da fala e "só a voz dela" na linha de áudio.
A fala apareceu escrita na tela?
Acrescente "sem legenda, sem texto na tela" no fim do prompt. Se quiser legenda, ponha depois, no editor do app em que vai postar.
Preciso avisar que o vídeo da influencer IA é gerado?
Sim. No TikTok, as diretrizes publicadas em 25/08/2026 e em vigor desde 24/09/2026 pedem rótulo em conteúdo gerado por IA e em conteúdo muito editado que mostre pessoas ou cenas de aparência realista; sem rótulo, o vídeo pode ser removido, restringido ou rotulado pela equipe do TikTok (Diretrizes da Comunidade do TikTok, conferido em 11/11/2026). No YouTube, a declaração vale pra conteúdo realista feito ou alterado com IA, e os exemplos da plataforma incluem fazer parecer que alguém deu conselhos que não deu e mostrar uma cena realista que não aconteceu (Central de Ajuda do YouTube, conferido em 11/11/2026). No Instagram e no Facebook, a Meta exige rótulo também em áudio realista criado ou alterado digitalmente, e pode aplicar penalidades a quem não marcar (Meta, 06/02/2024, conferido em 05/11/2026). O passo a passo de cada rede está no guia influencer IA precisa avisar que é IA?. Além disso, segundo a página oficial do Gemini Omni, conferida em 04/11/2026, o conteúdo criado com o Omni no app Gemini, no Google Flow ou no YouTube leva a marca d'água invisível SynthID e as credenciais de conteúdo C2PA.
Posso usar a voz de uma pessoa real?
Só com autorização de quem é dono da voz, de preferência por escrito, pra ter prova. A Constituição protege, nos termos da lei, "a reprodução da imagem e voz humanas" (art. 5º, XXVIII, a, Constituição Federal, conferido em 05/11/2026). E o YouTube trata como conteúdo a declarar o vídeo que faz uma pessoa real parecer dizer algo que não disse; clonar a própria voz pra narração ou dublagem fica fora dessa regra (Central de Ajuda do YouTube, conferido em 05/11/2026).
Na prática: não peça no prompt a voz "igual à de" um famoso, e não use áudio de outra pessoa como base sem autorização. Se o vídeo for de produto no TikTok Shop, a regra de IA da loja proíbe imitar a identidade ou a voz de alguém, como mostra o guia de influencer IA no TikTok Shop. O mesmo cuidado vale pro rosto, e os riscos estão no guia influencer IA parecida com pessoa real.
Como este guia foi feito
Pesquisa e redação com apoio de IA; as fontes oficiais do Google foram conferidas em 04/11/2026, a Constituição, a regra da Meta e a do YouTube sobre voz, em 05/11/2026, e as regras de rótulo do TikTok e do YouTube, em 11/11/2026. As imagens são gerações e telas reais da Avatrix, mostradas no guia do influencer IA de nicho. O número de vídeos vem do banco de dados de produção da Avatrix, no período de 7 de março a 1º de junho de 2026.
Perguntas frequentes
Use um modelo de vídeo que gera o áudio junto com a imagem, anexe uma foto da influencer como referência e escreva a fala dentro do prompt, dizendo o idioma e o jeito de falar. Na Avatrix, isso é um card de Vídeo no modo Criativo com o Gemini Omni Flash 1.1, que gera vídeos de 3 a 10 segundos com áudio nativo.
Não, com modelo de áudio nativo. A voz, a boca e o som ambiente saem na mesma geração, a partir do texto do prompt. No vídeo do Seu João, mostrado no guia do influencer IA de nicho, a fala inteira em português saiu do próprio modelo, sem gravação nem edição.
Fala. O vídeo do Seu João saiu em português brasileiro, com a boca acompanhando a fala. Mas a página oficial do Gemini Omni, conferida em 04/11/2026, não publica uma lista de idiomas, então escreva no prompt 'fala em português brasileiro' e confira cada vídeo antes de postar.
Os motivos mais comuns são fala longa demais pra duração do vídeo, rosto de perfil ou com mão e objeto na frente da boca, e prompt sem dizer que é ela quem fala. Encurte a fala, use uma foto de entrada de frente e com as mãos vazias e escreva quem fala e em que idioma.
Cada geração no Omni Flash 1.1 vai até 10 segundos, então vídeo longo sai de vários trechos. Pra apresentador falando por minutos sem corte, ferramentas de avatar falante, como o HeyGen, foram feitas pra isso, como mostra o comparativo Avatrix vs HeyGen.
No caminho com áudio nativo, o sotaque vai descrito no prompt, junto com a idade, o timbre e o ritmo da voz. No vídeo do Seu João, o prompt pedia 'sotaque caipira caloroso de vô do interior, voz grave e pausada'. Repita a mesma descrição em todo vídeo pra manter a voz parecida, e ouça cada vídeo antes de postar.
Só com autorização de quem é dono da voz, de preferência por escrito, pra ter prova. A Constituição protege a reprodução da imagem e da voz humanas (art. 5º, XXVIII, a), e o YouTube exige declaração quando o conteúdo faz uma pessoa real parecer dizer algo que não disse. Clonar a sua própria voz pra narrar é diferente: o YouTube lista isso entre os casos que não precisam de declaração.
Sim. TikTok e YouTube pedem rótulo em conteúdo realista feito com IA. Segundo a página oficial do Gemini Omni, conferida em 04/11/2026, o conteúdo criado com o Omni no app Gemini, no Google Flow ou no YouTube leva a marca d'água invisível SynthID e as credenciais C2PA.