LoRA é um arquivo pequeno de ajuste, treinado com fotos da mesma pessoa, que ensina um rosto a um modelo de imagem pra ele gerar a sua influencer IA sem você anexar foto em toda geração. É um dos jeitos de chegar na consistência de rosto, o termo mais importante deste glossário, ao lado de imagem de referência, face swap, UGC e lipsync.
Este glossário é da equipe da Avatrix, plataforma brasileira de influencer IA e dona deste blog. Os termos valem pra qualquer ferramenta.
O que é LoRA, em poucas palavras?
LoRA é a sigla de Low-Rank Adaptation (adaptação de baixo posto). A técnica foi publicada em junho de 2021 por Edward J. Hu e outros pesquisadores, no artigo LoRA: Low-Rank Adaptation of Large Language Models (conferido em 12/11/2026). A ideia: em vez de treinar o modelo inteiro de novo, ela congela os pesos originais e treina só umas matrizes pequenas, encaixadas por cima. No teste do artigo com o GPT-3 175B, isso reduziu em 10.000 vezes o número de parâmetros treináveis e em 3 vezes a memória de GPU necessária, sem perder qualidade em relação ao ajuste completo.
O artigo nasceu pra modelo de texto, mas a técnica foi parar nos modelos de imagem. A documentação do Diffusers, da Hugging Face (conferida em 12/11/2026), chama a LoRA de técnica de treino "leve", que deixa o treino mais rápido, gasta menos memória e gera um arquivo de pesos de "algumas centenas de MB", fácil de guardar e compartilhar.
Como o LoRA funciona numa influencer IA?
Em três passos:
- Você junta fotos da personagem. Todas com o mesmo rosto, em ângulos, expressões e luzes diferentes.
- A ferramenta treina o LoRA. O resultado é aquele arquivo pequeno, ligado a um modelo de imagem específico.
- Você gera com o LoRA ligado. O modelo já "sabe" o rosto, e o prompt descreve só a cena.
Quantas fotos o LoRA de rosto pede?
Cada ferramenta tem a sua regra. Duas, nas páginas de ajuda oficiais (conferidas em 12/11/2026):
| Ferramenta | Mínimo de fotos | O que a ajuda recomenda |
|---|---|---|
| Elements, do Leonardo | 10 (mais é melhor; teto de 50 no Flux Dev) | Incluir fotos de meio corpo e corpo inteiro pra evitar overfitting de composição; baixar a força se aparecer glitch |
| Soul ID, do Higgsfield | 20 (até 80) | Fotos bem iluminadas, ângulos e expressões variados, pelo menos uma de corpo inteiro, nada de óculos escuros, e só fotos suas ou de quem autorizou |
Um aviso se repete: as duas pedem foto de meio corpo ou corpo inteiro, e não só close.
Quando vale treinar um LoRA?
Quando a personagem já está aprovada e você vai gerar muito. Numa personagem inventada existe o problema do ovo e da galinha: as fotos de treino precisam sair de outro método antes, geralmente da imagem de referência. Por isso o LoRA vem depois, não no lugar dela. O passo a passo dos dois caminhos está no guia de personagem consistente com IA.
O que é consistência de rosto?
É a personagem ter a mesma cara em todo post: formato do rosto, olhos, nariz, linha do cabelo, idade e marcas no lugar certo. Sem isso, o seguidor vê uma sequência de pessoas diferentes, e a personagem deixa de existir.
O modelo de imagem não guarda quem é a sua personagem. Cada geração nasce do zero, e um texto como "mulher de 24 anos, cabelo cacheado" descreve milhares de rostos. Por isso a consistência depende de uma âncora: uma foto, um personagem salvo ou um LoRA.
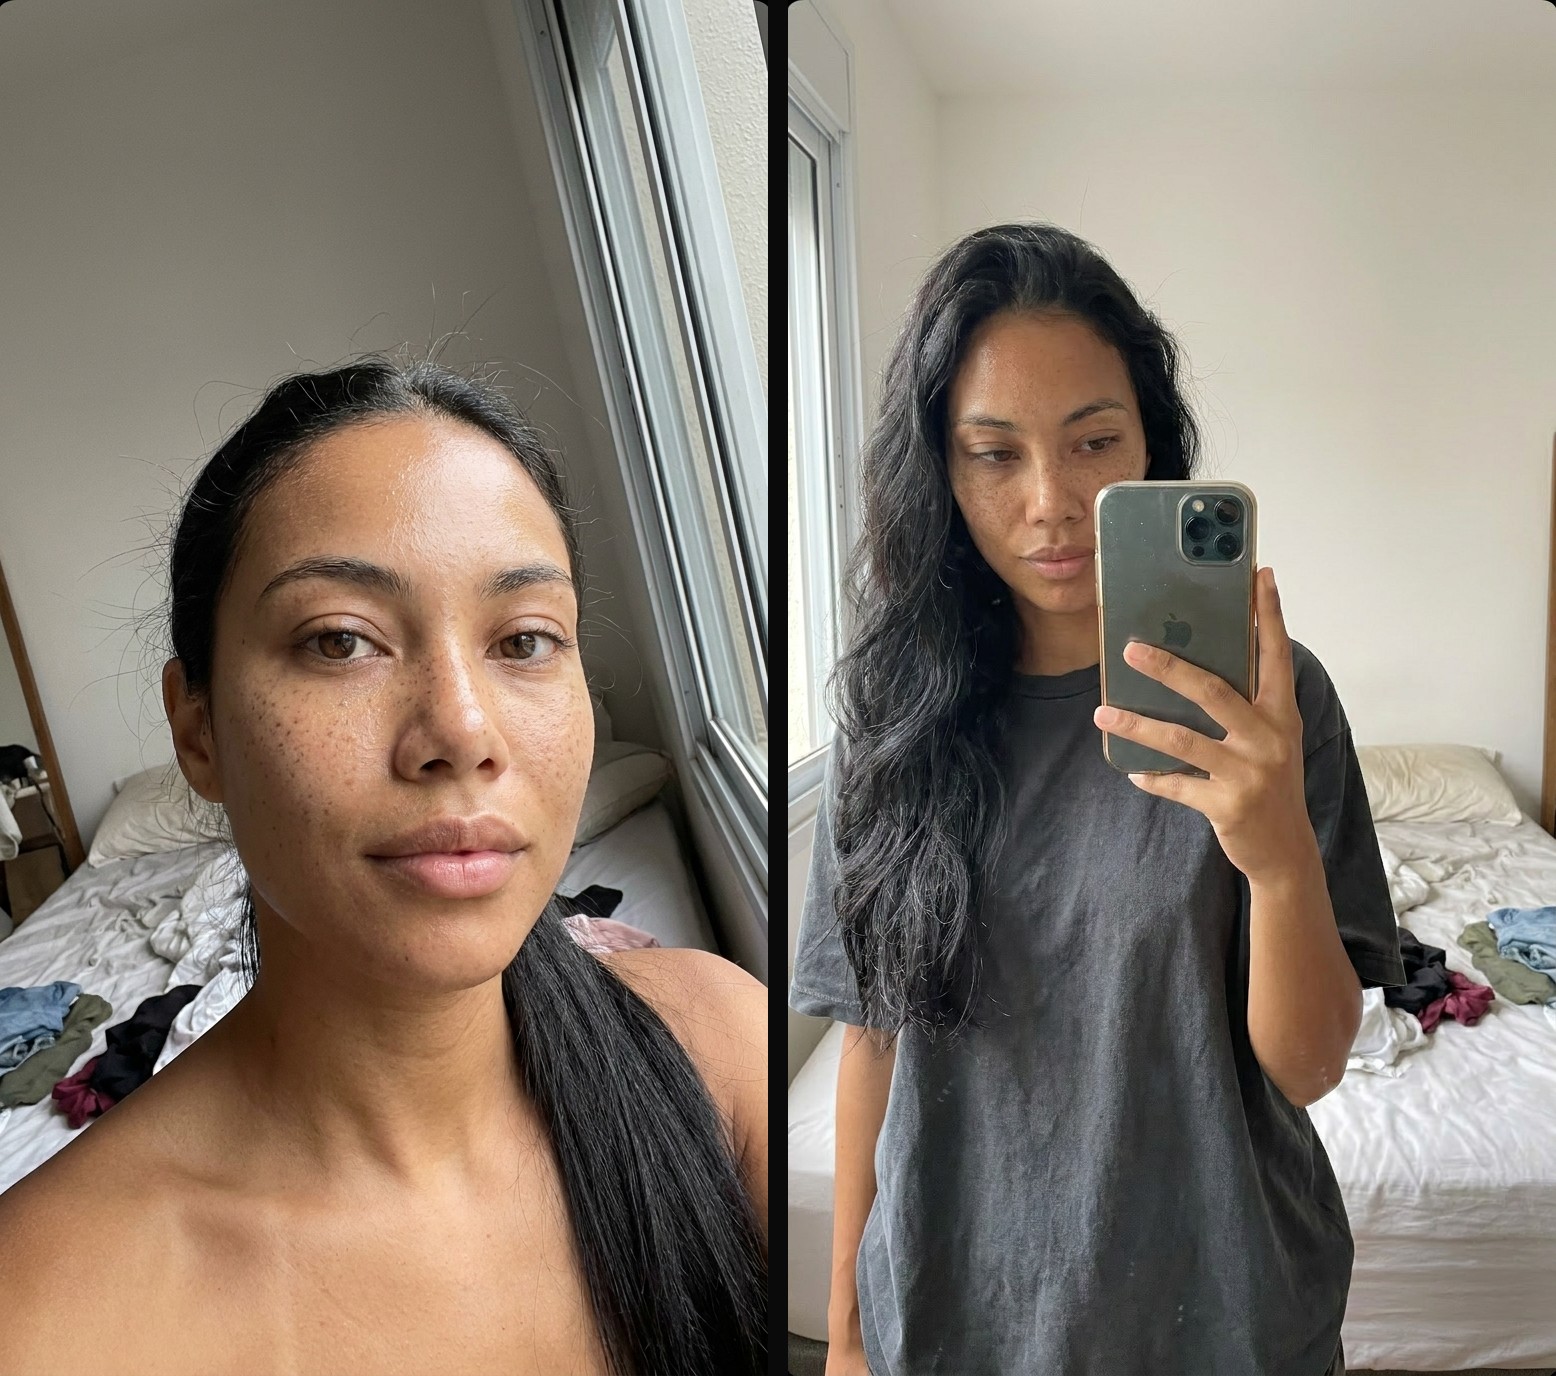
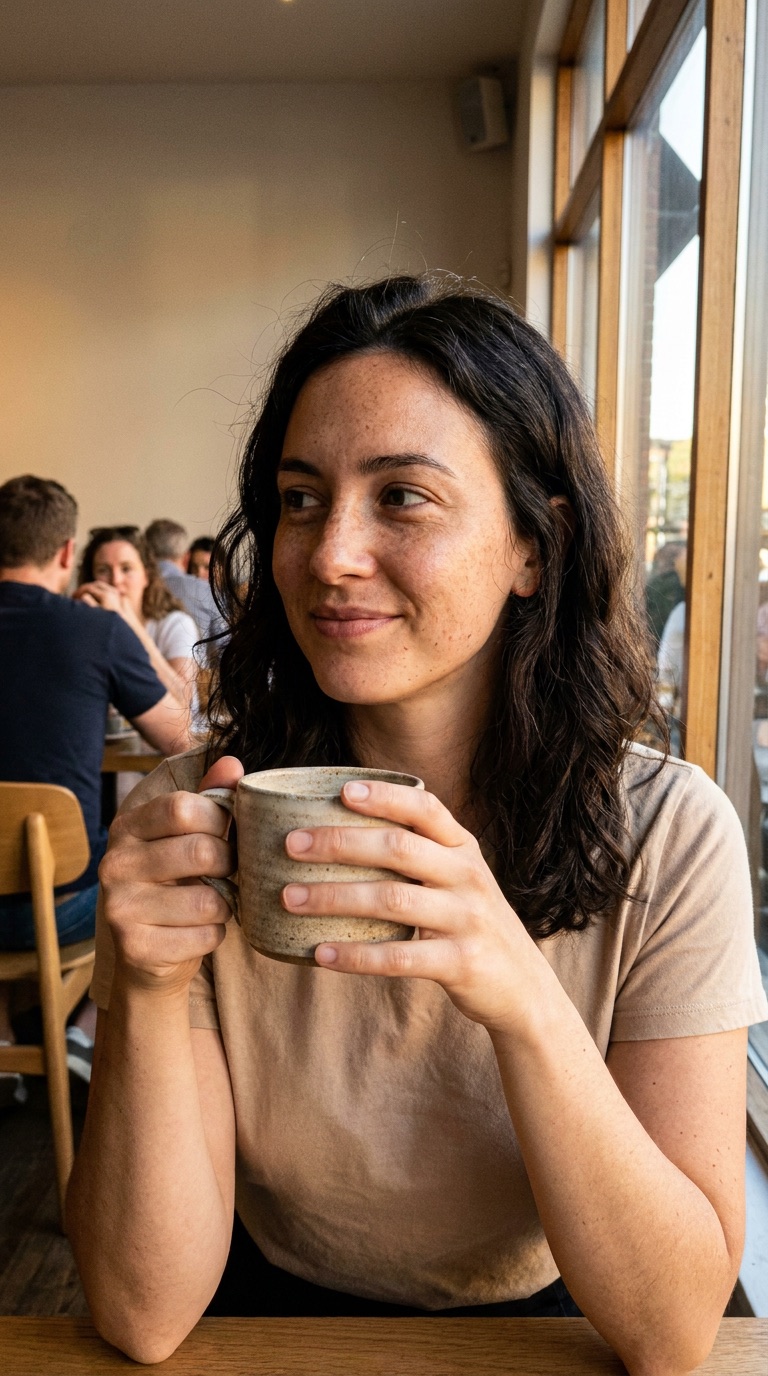
A Lia, acima, saiu nas duas cenas com a mesma imagem de referência anexada, sem LoRA. O que acontece quando a referência fica de fora aparece no próximo termo.
O que é imagem de referência?
É a foto da personagem que você anexa na geração pra dizer ao modelo "é essa pessoa". É o jeito mais rápido de segurar o rosto: não pede treino e funciona com uma foto boa. Na Avatrix, ela nasce no Criar Influencer e é anexada pelo botão "+ Anexar referência", como mostra o guia da influencer Lia.
Sem ela, o modelo inventa outra pessoa:
O que é âncora, ou foto-base?
É a imagem de referência oficial da personagem, a que você reanexa sempre. A regra é não usar a última foto gerada como referência da próxima, porque o erro se acumula como cópia de cópia.
O que é personagem salvo?
É a imagem de referência guardada pela plataforma, pra você chamar a personagem sem anexar nada. Na Avatrix, ela fica em Personagens e entra no Chat IA pelo chip "Escolher personagem", como no guia da Bia no Chat IA.
O que é face swap, ou troca de rosto?
É pegar uma cena pronta e trocar só o rosto pelo da personagem, mantendo corpo, roupa, fundo e luz. Diferente da imagem de referência, o face swap não cria cena nova: ele edita uma que já existe. Na Avatrix, a ferramenta se chama Trocar Personagem.
O que denuncia uma troca mal feita: emenda na mandíbula, luz do rosto vindo de um lado diferente da cena e tom de pele diferente do pescoço.
O que é UGC?
UGC vem de user-generated content, conteúdo gerado pelo usuário. No marketing, virou o nome do vídeo com cara de cliente comum: gravado no celular, na vertical, com a pessoa falando do produto pra câmera, sem cara de comercial.
UGC com IA é esse formato com uma personagem gerada por IA no lugar da pessoa. Dois cuidados valem sempre:
- Sem depoimento falso. A personagem não usou o produto, então "usei e amei" ou antes e depois montado enganam o público.
- Rótulo e publi. Vídeo realista feito com IA pede o rótulo de IA da rede, e post pago pede a marcação de publicidade. O detalhe de cada rede está em influencer IA precisa avisar que é IA?.
O que é lipsync, ou sincronia labial?
É a boca da personagem se mexendo no tempo exato das palavras. Sem ela, o vídeo parece dublado. Existem dois jeitos principais:
- Áudio nativo: o modelo de vídeo gera a imagem e a voz juntas, a partir da fala escrita no prompt. Boca e voz nascem na mesma geração.
- Lipsync separado: você gera ou grava o áudio primeiro, e uma ferramenta ajusta a boca ao áudio depois. A voz fica idêntica de um vídeo pro outro, mas são mais etapas.
Na Avatrix, a fala entra no card de Vídeo, no modo Criativo:
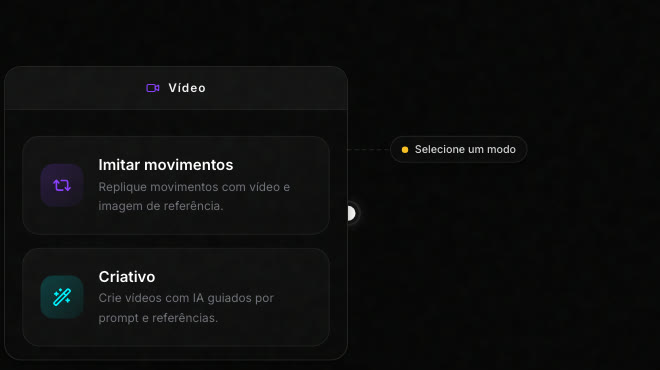
O passo a passo, com prompt pronto e o que fazer quando a boca sai fora do tempo, está no guia de influencer IA falando em vídeo.
O que é áudio nativo?
É quando o próprio modelo de vídeo gera o som junto com a imagem: voz, som ambiente e efeitos. Não precisa gravar nem dublar.
Que outros termos aparecem no dia a dia?
| Termo | O que é |
|---|---|
| Prompt | O texto que descreve o que você quer gerar. Em influencer IA, descreve a cena, não o rosto. |
| Modelo | A IA que gera a imagem ou o vídeo, como Nano Banana Pro, Seedream ou Kling. Cada um tem um estilo. |
| Workflow | Fluxo em cards ligados, em que o resultado de um card vira a entrada do próximo, como imagem que vira vídeo. |
| Controle de movimento | Copiar o movimento de um vídeo que já existe pra personagem, como uma dança. |
| Deriva | O rosto mudando aos poucos numa sequência longa de gerações. Corrige reanexando a âncora. |
| Palavra-gatilho | Termo que chama o LoRA no prompt, em ferramentas que usam esse esquema. |
| Rótulo de IA | O aviso que Instagram, TikTok e YouTube pedem em conteúdo realista feito com IA. |
Quais termos aparecem mais no uso real?
Na Avatrix, de 7 de março a 1º de junho de 2026, foram 5.132 gerações concluídas, e 4.626 delas saíram do Workflow. No mesmo período, a troca de personagem concluiu 105 gerações e o vídeo UGC, 65. Ou seja: o grosso do uso é o Workflow, o fluxo de cards, e não ferramentas soltas.
Se você está começando, a ordem que faz sentido é a mesma deste glossário: entender o que é influencer IA, fixar o rosto com imagem de referência, e só depois pensar em LoRA, UGC e fala. Na Avatrix, esse caminho fica na mesma conta, em português.
Como este guia foi feito
Pesquisa e redação com apoio de IA; o artigo do LoRA e as páginas oficiais da Hugging Face, do Leonardo e do Higgsfield foram conferidos em 12/11/2026. As imagens são gerações e telas reais feitas na Avatrix, as mesmas mostradas nos guias linkados. Os números da Avatrix vêm do banco de dados da plataforma, no período de 7 de março a 1º de junho de 2026.
Perguntas frequentes
LoRA (Low-Rank Adaptation) é um arquivo pequeno de ajuste, treinado com fotos da mesma pessoa, que se encaixa num modelo de imagem e ensina aquele rosto a ele. Depois do treino, o modelo gera a personagem sem você anexar foto a cada geração. A técnica congela o modelo original e treina só um punhado de pesos novos, por isso o treino é mais leve que treinar o modelo inteiro.
Depende da ferramenta. A ajuda do Leonardo pede no mínimo 10 imagens pro Elements, e a do Higgsfield pede 20 ou mais, até 80, pro Soul ID. Nas duas, a recomendação é variar ângulo e expressão e incluir foto de meio corpo ou corpo inteiro, e não só close.
Não. O caminho mais comum começa pela imagem de referência: você anexa a mesma foto-base em toda geração e descreve só a cena. O LoRA entra depois, quando você já tem fotos consistentes da personagem e vai gerar em volume.
UGC vem de user-generated content, conteúdo gerado pelo usuário. Em anúncio, é o vídeo com cara de cliente comum gravando no celular, falando do produto pra câmera. Em influencer IA, é esse mesmo formato com uma personagem gerada por IA no lugar da pessoa, e o post precisa do rótulo de IA e, se for pago, da marcação de publicidade.
Lipsync, ou sincronia labial, é a boca da personagem se mexendo no tempo exato das palavras. Pode sair junto com o vídeo, num modelo de áudio nativo, ou ser ajustada depois, numa ferramenta que casa a boca com um áudio pronto.
A imagem de referência guia a criação de uma cena nova com o rosto da personagem. O face swap, ou troca de rosto, parte de uma cena já pronta e troca só o rosto, mantendo corpo, roupa, fundo e luz.